美國農業部森林局(USDA Forest Service)所維護的森林清查與分析數據市集(Forest Inventory and Analysis DataMart,簡稱 FIA DataMart),為全美各地跨所有權類型的森林清查數據提供官方公開數據交換中心。該平台透過標準化表格萃取、州級 SQLite 資料庫以及分析工具輸入介面,支援總面積超過 7,000 英畝的森林資源評估。
森林清查數據的法源依據與核心範疇
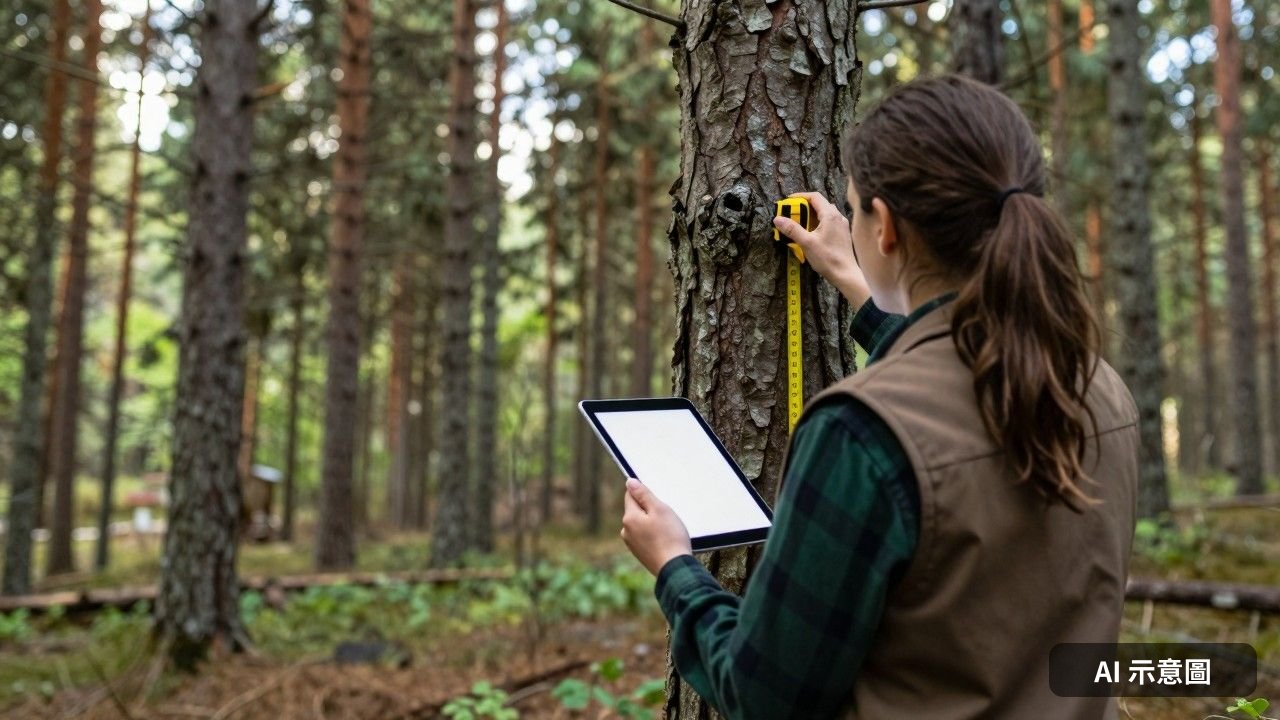
FIA 計劃源自 1978 年通過的《森林與牧場可再生資源研究法》(Forest and Rangeland Renewable Resources Research Act)及後續的農業法案,持續在全美 50 州、波多黎各、美屬維京群島及太平洋領地進行實地清查。平台運作涵蓋五大核心測量維度,包含森林面積動態、生長林木蓄積量、碳儲存量與生物量、林分結構以及干擾因子監測。
資料格式與多元取得途徑
為了配合研究人員的分析工作流程,FIA DataMart 提供多種取得格式,包含以州為單位的逗號分隔值(CSV)壓縮壓縮檔、預先封裝的 SQLite 資料庫,以及專為森林植被模擬器(Forest Vegetation Simulator,簡稱 FVS)設計的輸入檔案。使用者可透過地理與時間範圍篩選、下載壓縮檔、驗證關聯完整性,並在本地環境建立索引來進行資料檢索。
私有土地隱私保護與空間座標處理
根據 1985 年《糧食安全法》(Food Security Act)第 1770 條及 1998 年農業法案修正案的隱私規定,美國農業部森林局依法不得公開私有土地實地樣區的確切座標。為平衡土地所有權人隱私與區域生態研究的需求,森林局對私有樣區位置採用雙層擾動演算法,包含座標模糊化以及座標交換技術。
以抽樣權數為基礎的人口估計設計
為了避免直接計算算術平均數產生抽樣偏差,該計劃採用三階段機率框架,結合遙感影像分層、系統性地面樣區網格以及森林健康指標。透過 FIADB 架構內建的人口評估與分層權數表格,分析人員能夠將個別樣區測量值按比例擴展至景觀層級總量,確保實地清查結論具備統計上的有效性。
從中立客觀的角度來看,FIA DataMart 透過法規規範隱私與科學抽樣的平衡,為生態學家與資源分析師提供了一套標準化的實證基礎。不過,研究人員在處理私有土地數據時,必須留意座標模糊化所帶來的空間錯配限制,若需要高精度分析,仍須透過正式研究提案在安全環境中進行。
後續觀察
隨著生態建模需求日益增加,相關研究人員與機構持續關注聯邦森林清查數據在自動化查詢與跨世代比較上的技術演進,未來資料集的更新頻率與存取介面優化將是評估資料可用性的重要指標。
建議使用者在進行跨州分析或大範圍生態評估時,務必先行確認各州清查週期與資料表之間的關聯完整性,並針對私有土地的空間限制採取適當的統計方法。
本文改寫整理自公開新聞來源,原始報導由CASRAI發布。
常見問題 FAQ
什麼是 FIA DataMart?
FIA DataMart 是美國農業部森林局維護的官方公開數據交換中心,提供全美跨所有權類型的森林清查數據下載與標準化分析工具輸入介面。
為什麼私有土地的樣區座標會被修改?
根據美國聯邦法律與隱私規定,森林局必須保護土地所有權人隱私並防止商業剝削,因此對私有土地樣區採用座標模糊化與座標交換技術。
研究人員可以如何取得這些森林清查數據?
研究人員可以透過官方入口網站下載州級 CSV 壓縮檔、預先封裝的 SQLite 資料庫,或使用 R 語言的 rFIA 套件與 REST API 進行檢索與分析。
※ 此篇文章由 AI 改寫或生成,內容僅供參考,可能存在錯誤或不準確之處。
Author

Related Posts