人工智慧真的能在一瞬間解決所有科學難題嗎?當演算法開始深入基因體、蛋白質結構甚至臨床開發,我們看見的是效率狂飆的科研奇蹟,還是資料管理失控的隱形危機?事實上,這場技術革命正在重新定義整個科學界的遊戲規則。
現象觀察:AI 正在重塑科學研究的底層邏輯
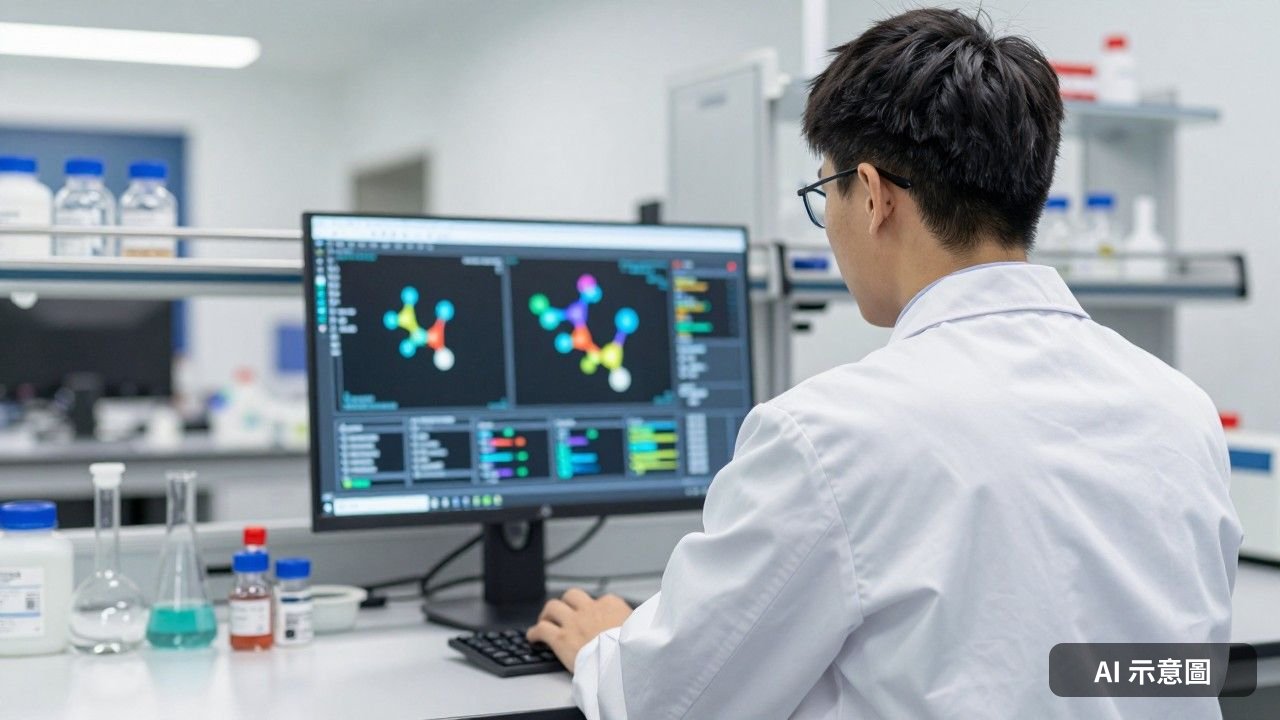
人工智慧在科學領域的滲透速度遠超預期,它早就不只是單純的分析工具。從基因體學到藥物研發,演算法正扮演著假說生成、實驗設計乃至跨領域合作的核心驅動力。研究人員利用 AI 代理系統在極短時間內處理龐大數據,找出潛在的生物機制。這股力量大幅縮短了研究週期,也降低了部分營運成本。不過,當 AI 展現出驚人的預測與分析能力時,科研生態系也隨之被推向了全新的壓力測試點。
原因剖析:資料治理與信任機制的結構性失靈
說真的,AI 越聰明,我們對資料本身的挑剔程度就得越高。首先,資料品質成為首要痛點,如果研究數據依然分散在彼此不相容的系統中,演算法不但無法發揮效用,反而會放大資料管理的零散問題。其次,在受監管的環境裡,明確的用途定義、治理規範與嚴格的稽核紀錄,向來是技術落地的先決條件。再者,許多應用仍停留在概念驗證階段,資料偏誤、可解釋性不足以及可重現性挑戰,才是阻礙技術真正走向長期的核心障礙。
影響評估:從技術新穎性轉向可驗證的實際影響
回過頭來看,科學界對這項技術的期待已經變得更加務實。與其盲目追求技術的新奇,越來越多聲音主張,必須以可量化且可驗證的實際影響來評估價值。這意味著我們必須檢視 AI 是否真正縮短了研究時間、提升自動化程度,甚至帶來制度層面的改變。特別是在醫療與生物醫學等高度敏感的領域,唯有具備高度可信度與可解釋性的系統,才有機會獲得監管機構與臨床實務的真正接受。
從產業面來看,當 AI 成為科研的重要參與者,我們面臨的早已不是技術能不能做到的問題,而是「我們是否信任這個結果」的信任危機。對研究機構來說,資料責任與驗證標準的建立,將是決定未來科研競爭力的關鍵分水嶺。如果連基礎的資料追溯性都做不到,再強大的演算法也只是空中樓閣。
趨勢預測:迎向人機協作與標準重定義的新時代
展望未來的科學運算生態系,兼顧信任與人機協作將是唯一的解方。首先,科研機構必須全面升級資料的語意治理與格式一致性。其次,驗證機制的嚴謹度必須跟上 AI 的運算速度。再者,跨領域人才的培育將成為突破瓶頸的關鍵推手。最後,當資料品質與驗證標準建立後,AI 才能真正轉化為推動科學長遠發展的穩固基石。
如果你身處科研或相關產業,不妨思考一下:你的團隊目前準備好迎接這場資料治理的大考驗了嗎?面對隨時可能出爐的 AI 實驗結果,你們又建立起多少層次的驗證機制?這或許是接下來每位研究人員都必須嚴肅看待的課題。
本文改寫整理自公開新聞來源,原始報導由科技新報發布。
常見問題 FAQ
為什麼 AI 加速科學研究會面臨資料品質的瓶頸?
因為當 AI 越能從資料中挖掘價值,研究機構對資料來源、格式一致性、語意治理與可追溯性的要求就越高,若資料分散在不相容系統中,就會放大管理問題。
目前阻礙 AI 在科學領域廣泛採用的主要因素有哪些?
主要因素包含資料偏誤、可解釋性不足、外部驗證不夠、可重現性挑戰,以及跨領域人才短缺,且多數應用仍停留在概念驗證階段。
醫療與生物醫學領域對 AI 應用的核心要求是什麼?
在醫療與生物醫學等敏感領域,具備高度可解釋性與可信度的系統,才更有機會獲得監管機構與臨床實務的接受。
※ 此篇文章由 AI 改寫或生成,內容僅供參考,可能存在錯誤或不準確之處。
Author

Related Posts